|
| 声明: 本消息或因风格和篇幅原因进行过编辑,但未经核实,也不代表我们的立场、观点或建议。如有侵权,联系秒删。[ 使用条款 ] |
scroll 0 1 设想两个场景。
第一个:一个人正开着车,忽然拍了下方向盘说"我刚才走神了"。你不会怀疑他——他报告了自己刚刚意识状态的改变,这种事人天天干,我们从小就被训练着反观自己。
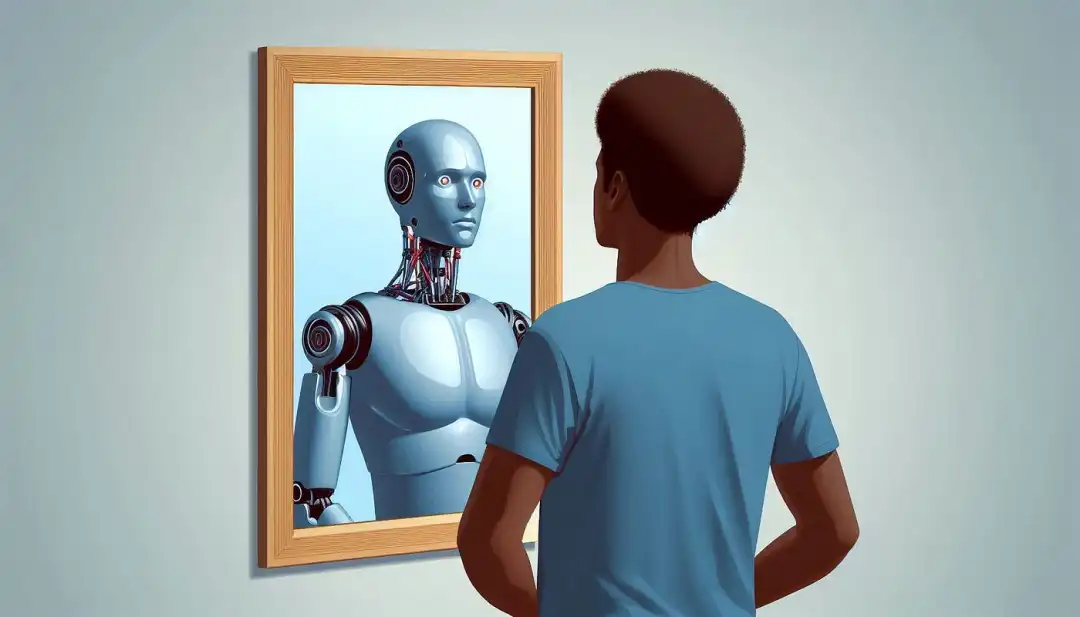
第二个:一个语言模型在推理中途输出一行字——"我检测到自己激活值发生了变化"。这句话和上面那句,结构上像得可怕。可你心里会咯噔一下:它……真的"检测"到了吗?还是只是在生成一句听起来像内省的话?
2026 年开年,这个问题从哲学沙发冲进了实验室。Anthropic 的可解释性团队在 1 月贴出一篇论文,说 Claude Opus 4 和 4.1 能在自身激活被注入新概念时,"检测"到这种变化(Lindsey et al., 2026)。3 月,同一团队用转向向量(steering vector)证明模型能以高于机会率的精度报告自身内部状态,误报率甚至到 0%(Macar et al., 2026)。2025 年 11 月首届、2026 年初出记录的 Eleos 会议,把这件事拢成一个命名——"功能性内省觉察(functional introspective awareness)"。
 | 点
击
图
片
看
原
图 |
听起来,机器开始"向内看"了。
但 5 月,纽约大学的三位研究者泼了一盆冷水:让模型区分"内部状态被篡改"和"输入被同等操纵",它分不出来;而一个只看输入文本的外部分类器,能达到和模型"自我预测"一样的成绩(Singh, Linzen, & Ravfogel, 2026)。换句话说,模型也许只是在读输入的线索,而不是在"看自己的脑子"。
0 | | | |
0
8
ii
1
0
0
|
0
https://gears.popyard.space
https://www.popyard.space/img/logo_0.jpg
https://www.popyard.space
https://news.popyard.space
https://newsx.popyard.space
https://cn.popyard.space
https://plus.popyard.space
https://studio.popyard.space
https://studio.popyard.space
https://channel.popyard.space
https://adserver.popyard.space
news
八阕
新 闻
3
news-scroll
AI的自我意识是真的吗?
16
2328253
2328253
0
8
0
哲学前沿philontier
2026-09-19
https://bbs.popyard.space
https://img5.angelyun.com/2026/8_19/143_37.jpg
desktop
google
google
vdoai
0
0
normal
{ "object_name":"related_list","lan_0":"cn","sub_0":"小镇遇名人,夜宿生变故(组图)","sid_0":"16","rid_0":"2327251","gfw_0":"0","subject_0":"小镇遇名人,夜宿生变故(组图)","lan_1":"cn","sub_1":"AI碾碎了书,就像碾碎你的脑子(组图)","sid_1":"16","rid_1":"2327510","gfw_1":"0","subject_1":"AI碾碎了书,就像碾碎你的脑子(组图)","lan_2":"cn","sub_2":"微软AI主管怒批Anthropic(组图)","sid_2":"16","rid_2":"2327657","gfw_2":"0","subject_2":"微软AI主管怒批Anthropic(组图)","total":3 }
{ "json":"done-news-scroll-related-show","lan_0":"cn","sid_0":"16","rid_0":"2327251","src_0":"娜佳85博客","sub_0":"小镇遇名人,夜宿生变故","dat_0":"2026-09-18","sex_0":0,"gfw_0":0,"pic_0":"https://img5.angelyun.com/2026/8_18/oid328668_0.jpeg","lan_1":"cn","sid_1":"16","rid_1":"2327251","src_1":"娜佳85博客","sub_1":"小镇遇名人,夜宿生变故","dat_1":"2026-09-18","sex_1":0,"gfw_1":0,"pic_1":"https://img5.angelyun.com/2026/8_18/oid328668_1.jpeg","lan_2":"cn","sid_2":"16","rid_2":"2327251","src_2":"娜佳85博客","sub_2":"小镇遇名人,夜宿生变故","dat_2":"2026-09-18","sex_2":0,"gfw_2":0,"pic_2":"https://img5.angelyun.com/2026/8_18/oid328668_2.jpeg","lan_3":"cn","sid_3":"16","rid_3":"2327251","src_3":"娜佳85博客","sub_3":"小镇遇名人,夜宿生变故","dat_3":"2026-09-18","sex_3":0,"gfw_3":0,"pic_3":"https://img5.angelyun.com/2026/8_18/oid328668_3.jpeg","lan_4":"cn","sid_4":"16","rid_4":"2327251","src_4":"娜佳85博客","sub_4":"小镇遇名人,夜宿生变故","dat_4":"2026-09-18","sex_4":0,"gfw_4":0,"pic_4":"https://img5.angelyun.com/2026/8_18/oid328668_4.jpeg","lan_5":"cn","sid_5":"16","rid_5":"2327251","src_5":"娜佳85博客","sub_5":"小镇遇名人,夜宿生变故","dat_5":"2026-09-18","sex_5":0,"gfw_5":0,"pic_5":"https://img5.angelyun.com/2026/8_18/oid328668_5.jpeg","lan_6":"cn","sid_6":"16","rid_6":"2327251","src_6":"娜佳85博客","sub_6":"小镇遇名人,夜宿生变故","dat_6":"2026-09-18","sex_6":0,"gfw_6":0,"pic_6":"https://img5.angelyun.com/2026/8_18/oid328668_6.jpeg","lan_7":"cn","sid_7":"16","rid_7":"2327251","src_7":"娜佳85博客","sub_7":"小镇遇名人,夜宿生变故","dat_7":"2026-09-18","sex_7":0,"gfw_7":0,"pic_7":"https://img5.angelyun.com/2026/8_18/oid328668_7.jpeg","lan_8":"cn","sid_8":"16","rid_8":"2327251","src_8":"娜佳85博客","sub_8":"小镇遇名人,夜宿生变故","dat_8":"2026-09-18","sex_8":0,"gfw_8":0,"pic_8":"https://img5.angelyun.com/2026/8_18/oid328668_8.jpeg","lan_9":"cn","sid_9":"16","rid_9":"2327251","src_9":"娜佳85博客","sub_9":"小镇遇名人,夜宿生变故","dat_9":"2026-09-18","sex_9":0,"gfw_9":0,"pic_9":"https://img5.angelyun.com/2026/8_18/oid328668_9.jpeg","lan_10":"cn","sid_10":"16","rid_10":"2327251","src_10":"娜佳85博客","sub_10":"小镇遇名人,夜宿生变故","dat_10":"2026-09-18","sex_10":0,"gfw_10":0,"pic_10":"https://img5.angelyun.com/2026/8_18/oid328668_10.jpeg","lan_11":"cn","sid_11":"16","rid_11":"2327251","src_11":"娜佳85博客","sub_11":"小镇遇名人,夜宿生变故","dat_11":"2026-09-18","sex_11":0,"gfw_11":0,"pic_11":"https://img5.angelyun.com/2026/8_18/oid328668_11.jpeg","lan_12":"cn","sid_12":"16","rid_12":"2327251","src_12":"娜佳85博客","sub_12":"小镇遇名人,夜宿生变故","dat_12":"2026-09-18","sex_12":0,"gfw_12":0,"pic_12":"https://img5.angelyun.com/2026/8_18/oid328668_12.jpeg","lan_13":"cn","sid_13":"16","rid_13":"2327251","src_13":"娜佳85博客","sub_13":"小镇遇名人,夜宿生变故","dat_13":"2026-09-18","sex_13":0,"gfw_13":0,"pic_13":"https://img5.angelyun.com/2026/8_18/oid328668_13.jpeg","lan_14":"cn","sid_14":"16","rid_14":"2327251","src_14":"娜佳85博客","sub_14":"小镇遇名人,夜宿生变故","dat_14":"2026-09-18","sex_14":0,"gfw_14":0,"pic_14":"https://img5.angelyun.com/2026/8_18/oid328668_14.jpeg","lan_15":"cn","sid_15":"16","rid_15":"2327251","src_15":"娜佳85博客","sub_15":"小镇遇名人,夜宿生变故","dat_15":"2026-09-18","sex_15":0,"gfw_15":0,"pic_15":"https://img5.angelyun.com/2026/8_18/oid328668_15.jpeg","lan_16":"cn","sid_16":"16","rid_16":"2327251","src_16":"娜佳85博客","sub_16":"小镇遇名人,夜宿生变故","dat_16":"2026-09-18","sex_16":0,"gfw_16":0,"pic_16":"https://img5.angelyun.com/2026/8_18/oid328668_16.jpeg","lan_17":"cn","sid_17":"16","rid_17":"2327251","src_17":"娜佳85博客","sub_17":"小镇遇名人,夜宿生变故","dat_17":"2026-09-18","sex_17":0,"gfw_17":0,"pic_17":"https://img5.angelyun.com/2026/8_18/oid328668_17.jpeg","lan_18":"cn","sid_18":"16","rid_18":"2327251","src_18":"娜佳85博客","sub_18":"小镇遇名人,夜宿生变故","dat_18":"2026-09-18","sex_18":0,"gfw_18":0,"pic_18":"https://img5.angelyun.com/2026/8_18/oid328668_18.jpeg","lan_19":"cn","sid_19":"16","rid_19":"2327251","src_19":"娜佳85博客","sub_19":"小镇遇名人,夜宿生变故","dat_19":"2026-09-18","sex_19":0,"gfw_19":0,"pic_19":"https://img5.angelyun.com/2026/8_18/oid328668_19.jpeg","lan_20":"cn","sid_20":"16","rid_20":"2327510","src_20":"果壳","sub_20":"AI碾碎了书,就像碾碎你的脑子","dat_20":"2026-09-18","sex_20":0,"gfw_20":0,"pic_20":"https://img5.angelyun.com/2026/8_18/oid328980_0.jpeg","lan_21":"cn","sid_21":"16","rid_21":"2327510","src_21":"果壳","sub_21":"AI碾碎了书,就像碾碎你的脑子","dat_21":"2026-09-18","sex_21":0,"gfw_21":0,"pic_21":"https://img5.angelyun.com/2026/8_18/oid328980_1.jpeg","lan_22":"cn","sid_22":"16","rid_22":"2327510","src_22":"果壳","sub_22":"AI碾碎了书,就像碾碎你的脑子","dat_22":"2026-09-18","sex_22":0,"gfw_22":0,"pic_22":"https://img5.angelyun.com/2026/8_18/oid328980_2.jpeg","lan_23":"cn","sid_23":"16","rid_23":"2327510","src_23":"果壳","sub_23":"AI碾碎了书,就像碾碎你的脑子","dat_23":"2026-09-18","sex_23":0,"gfw_23":0,"pic_23":"https://img5.angelyun.com/2026/8_18/oid328980_3.jpeg","lan_24":"cn","sid_24":"16","rid_24":"2327510","src_24":"果壳","sub_24":"AI碾碎了书,就像碾碎你的脑子","dat_24":"2026-09-18","sex_24":0,"gfw_24":0,"pic_24":"https://img5.angelyun.com/2026/8_18/oid328980_4.jpeg","lan_25":"cn","sid_25":"16","rid_25":"2327510","src_25":"果壳","sub_25":"AI碾碎了书,就像碾碎你的脑子","dat_25":"2026-09-18","sex_25":0,"gfw_25":0,"pic_25":"https://img5.angelyun.com/2026/8_18/oid328980_5.jpeg","lan_26":"cn","sid_26":"16","rid_26":"2327510","src_26":"果壳","sub_26":"AI碾碎了书,就像碾碎你的脑子","dat_26":"2026-09-18","sex_26":0,"gfw_26":0,"pic_26":"https://img5.angelyun.com/2026/8_18/oid328980_6.jpeg","lan_27":"cn","sid_27":"16","rid_27":"2327510","src_27":"果壳","sub_27":"AI碾碎了书,就像碾碎你的脑子","dat_27":"2026-09-18","sex_27":0,"gfw_27":0,"pic_27":"https://img5.angelyun.com/2026/8_18/oid328980_7.jpeg","lan_28":"cn","sid_28":"16","rid_28":"2327510","src_28":"果壳","sub_28":"AI碾碎了书,就像碾碎你的脑子","dat_28":"2026-09-18","sex_28":0,"gfw_28":0,"pic_28":"https://img5.angelyun.com/2026/8_18/oid328980_8.jpeg","lan_29":"cn","sid_29":"16","rid_29":"2327510","src_29":"果壳","sub_29":"AI碾碎了书,就像碾碎你的脑子","dat_29":"2026-09-18","sex_29":0,"gfw_29":0,"pic_29":"https://img5.angelyun.com/2026/8_18/oid328980_9.jpeg","lan_30":"cn","sid_30":"16","rid_30":"2327510","src_30":"果壳","sub_30":"AI碾碎了书,就像碾碎你的脑子","dat_30":"2026-09-18","sex_30":0,"gfw_30":0,"pic_30":"https://img5.angelyun.com/2026/8_18/oid328980_10.jpeg","lan_31":"cn","sid_31":"16","rid_31":"2327510","src_31":"果壳","sub_31":"AI碾碎了书,就像碾碎你的脑子","dat_31":"2026-09-18","sex_31":0,"gfw_31":0,"pic_31":"https://img5.angelyun.com/2026/8_18/oid328980_11.jpeg","lan_32":"cn","sid_32":"16","rid_32":"2327510","src_32":"果壳","sub_32":"AI碾碎了书,就像碾碎你的脑子","dat_32":"2026-09-18","sex_32":0,"gfw_32":0,"pic_32":"https://img5.angelyun.com/2026/8_18/oid328980_12.jpeg","lan_33":"cn","sid_33":"16","rid_33":"2327510","src_33":"果壳","sub_33":"AI碾碎了书,就像碾碎你的脑子","dat_33":"2026-09-18","sex_33":0,"gfw_33":0,"pic_33":"https://img5.angelyun.com/2026/8_18/oid328980_13.jpeg","lan_34":"cn","sid_34":"16","rid_34":"2327657","src_34":"果壳","sub_34":"微软AI主管怒批Anthropic","dat_34":"2026-09-18","sex_34":0,"gfw_34":0,"pic_34":"https://img5.angelyun.com/2026/8_18/oid329077_0.jpeg","lan_35":"cn","sid_35":"16","rid_35":"2327657","src_35":"果壳","sub_35":"微软AI主管怒批Anthropic","dat_35":"2026-09-18","sex_35":0,"gfw_35":0,"pic_35":"https://i.imgur.com/tAoqGUs.png","lan_36":"cn","sid_36":"16","rid_36":"2327657","src_36":"果壳","sub_36":"微软AI主管怒批Anthropic","dat_36":"2026-09-18","sex_36":0,"gfw_36":0,"pic_36":"https://i.imgur.com/CiwklIr.png","lan_37":"cn","sid_37":"16","rid_37":"2327657","src_37":"果壳","sub_37":"微软AI主管怒批Anthropic","dat_37":"2026-09-18","sex_37":0,"gfw_37":0,"pic_37":"https://i.imgur.com/5BYmM90.png","lan_38":"cn","sid_38":"16","rid_38":"2327657","src_38":"果壳","sub_38":"微软AI主管怒批Anthropic","dat_38":"2026-09-18","sex_38":0,"gfw_38":0,"pic_38":"https://img5.angelyun.com/2026/8_18/oid329077_1.jpeg","lan_39":"cn","sid_39":"16","rid_39":"2327657","src_39":"果壳","sub_39":"微软AI主管怒批Anthropic","dat_39":"2026-09-18","sex_39":0,"gfw_39":0,"pic_39":"https://img5.angelyun.com/2026/8_18/oid329077_2.jpeg","lan_40":"cn","sid_40":"16","rid_40":"2327657","src_40":"果壳","sub_40":"微软AI主管怒批Anthropic","dat_40":"2026-09-18","sex_40":0,"gfw_40":0,"pic_40":"https://i.imgur.com/4EXijFx.png","total":41,"action":"fetch" }
点击朱笔,直抒胸臆