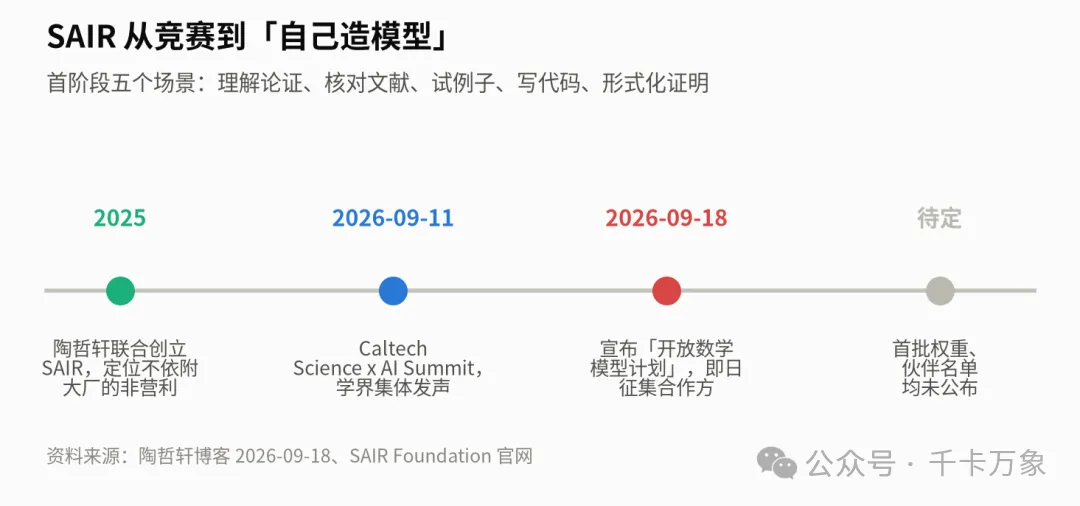
9 月 18 日,菲尔兹奖得主陶哲轩代表 SAIR Foundation 宣布启动「开放数学模型计划」(Open Math Model),联合学术界和产业界,为数学与基础科学研究做开放权重模型和配套开源工具链。首阶段只盯日常科研里最常见的几件事,读懂难论证、核对文献、试例子、写代码、形式化证明。模型和代码走 Apache 2.0、MIT、CC BY 4.0 这类开放许可;训练数据要带来源和权限说明;评测要能被独立团队复现;发布时要同时报告失败和局限,不能只报成绩。计划即日起征集资金、算力、专业经验和社区建设方面的合作伙伴,伙伴名单尚未公布。陶哲轩在声明里写得很直白,这个组织从去年成立起就不依附任何大型 AI 公司。 公告里最硬的一条,是数据归谁 七条原则里,别的都常见,少见的是数据归属那句。数学社区拥有数据,也决定数据怎么用;拿用户数据去训练或改进模型,必须事先谈好条件、并且获得明确同意,研究者自己选分享什么、分享给什么用途。 这句话放在 2026 年 9 月,分量不轻。过去一年,模型厂商和内容方、代码托管方、学术出版方为了训练数据打成一团。有起诉,有改条款,还有平台把旧书买下来扫完销毁。数学界手里握着的恰是最难替代的一类数据,论文、证明、审稿意见、讨论记录,还有那些没法写进论文的失败尝试。现在有人站出来说,这些东西不外包,由社区自己管。 配套的是知识产权和治理两条。联合开发的模型、代码、工具用开放许可共享,贡献者的署名、许可和归属要在动工之前就谈清楚;研究者原有的独立成果仍归自己,数学想法和结果照样拿 credit。治理规则和决策公开,成员可以提修改、参与决策、问责负责人。产业伙伴可以出算力和资源,但声明里专门加了一句,这些合作必须保住研究社区的独立性。
首阶段不碰「证明千禧年难题」,先干科研杂活 计划第一阶段列了五个场景,理解困难的论证、核对参考文献、探索例子、写代码、形式化证明。都是研究者每天要花大量时间、但很难讲成头条的活。 价值衡量标准也定得很土,可靠的帮助、可验证的结果、以及持续用下去的成本。三个词里两个和钱有关,陶哲轩这套东西从立项起就盯着「用得起」,而不是「能不能刷榜」。 |
| |||||||||||

点击朱笔,直抒胸臆