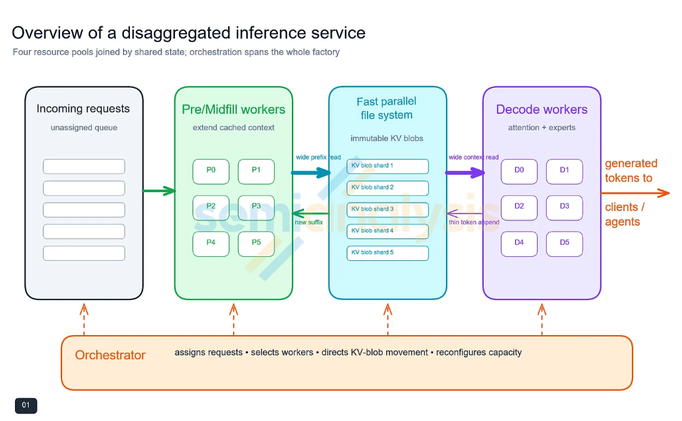
MoE架构将推理拆解为预填充、中间填充、解码注意力与解码专家四个阶段,各阶段硬件需求截然不同。Semianalysis认为内存带宽比内存容量更值钱,堆容量不如提速度。聚合式与分离式架构之争本质是"全能芯片"能否实现的赌注。调度层成为隐形价值洼地,KV缓存分级存储管理将催生新兴存储赛道机会。 当你向AI提问并收到回复,这个看似瞬间完成的交互背后,是一套横跨计算、存储、内存与网络调度的复杂工业体系。 9月22日,研究机构SemiAnalysis发布深度技术报告,系统拆解了大模型推理服务的底层架构。从用户发出请求到AI生成每一个token,每个环节如何运作、哪里是瓶颈、什么样的硬件在什么阶段真正创造价值。 报告指出,推理服务并非一个整体,而是由预填充(Prefill)、中间填充(Midfill)、解码注意力(Decode Attention)和解码专家(Decode Experts)四个工作阶段构成的"Token工厂"。 这一分析框架对于理解AI基础设施竞争的核心逻辑具有重要参考价值。每个阶段对算力、内存带宽和网络的需求截然不同,混同处理将损失混合专家(MoE)模型架构的结构性优势。 报告以英伟达Blackwell系列GPU为案例进行推演,其结论对硬件设计者、云服务商和模型部署方均具有直接指导意义。 "专家工厂"的诞生:MoE改变了什么 过去,我们讨论大模型,习惯用参数量说话——千亿、万亿,数字越大越震撼。但MoE的出现,让这种比较方式变得苍白。它真正改变的,不再是参数的总量,关键是哪些参数在哪个时刻被激活。 具体来说:每次处理一个词元Token(可以简单理解为一个词或一个字),MoE模型不会让全部参数都参与计算。它有一个"路由器",会为每个Token精准定位出少数几个最合适的"专家模块",让这些专家各司其职,处理完再把结果汇总。 这就好比一家超级医院,每个病人进门不是被所有科室的医生轮流问诊,而是智能分诊系统直接把他送到最对口的两三位专科医生面前。 这个机制带来了一系列连锁反应: 哪些数据必须"住"在离计算最近的地方,发生了根本变化; 内存、带宽、存储的价值权重,被彻底重新排列; |
| |||||||||||||||||||||
点击朱笔,直抒胸臆