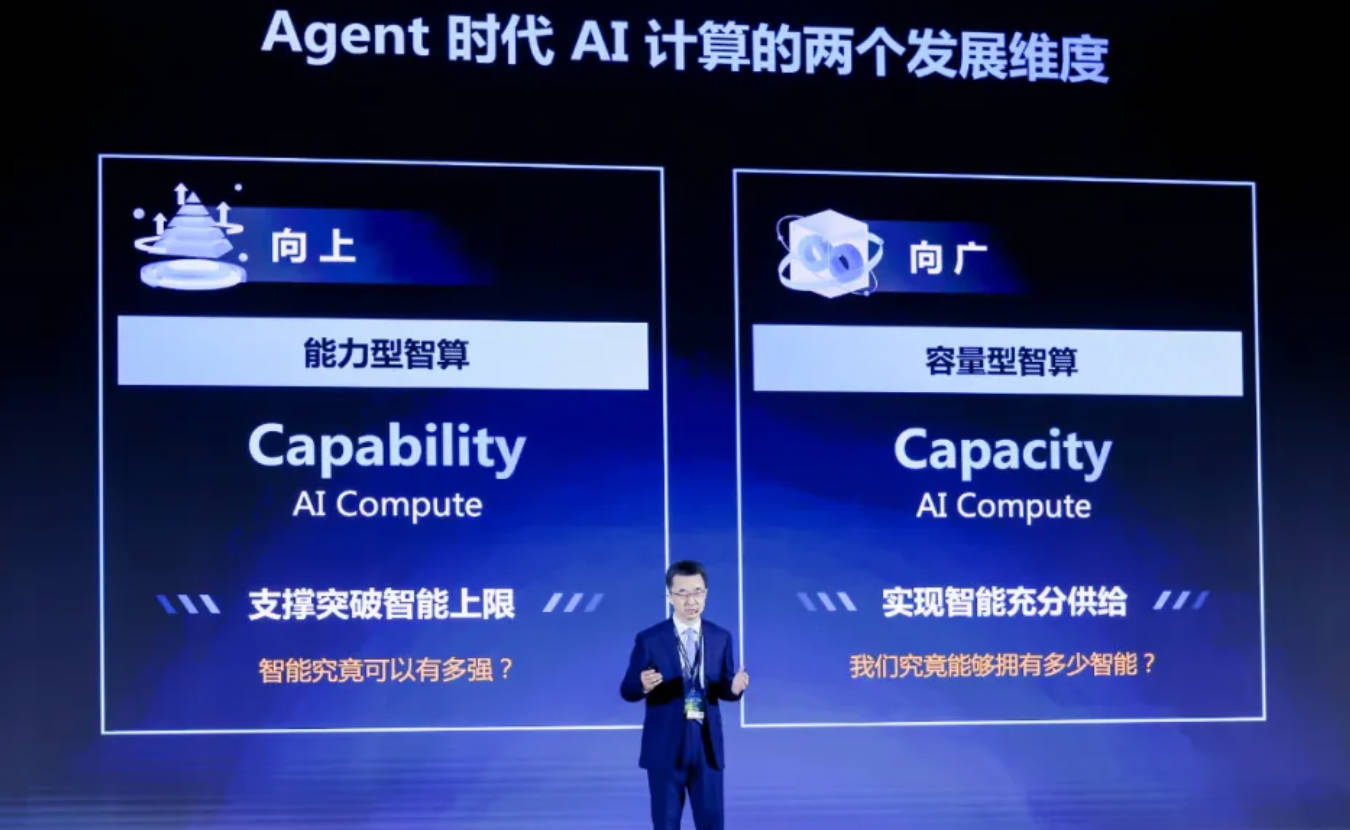
AI算力的竞争,多年来就一个字——堆。 堆卡、堆机柜、堆发电机……似乎计算卡足够多、集群足够大,就能站在食物链顶端。 但算力「够不够用」这个问题,已经不再能单靠堆卡来解决,它开始分化出越来越多的层面。 第一个问题关于智能上限,也就是你的算力能撑起多强的智能。 前沿模型的参数规模、上下文长度、推理深度在同时变大,Agent可能连续运行几个小时甚至几天。 模型在一台机器里装不装得下、跑得快不快、长时间跑起来稳不稳,都需要被重新考量。 另一个问题是智能规模,这个问题更直击灵魂——你的算力能以多低的成本生产多少智能? Token需求在爆发,但推理负载是多元的,Prefill和Decode的计算特征不同,堆同一种算力已经覆盖不了这些差异。 智能上限和智能规模,两个问题各自独立,又相互关联,只解决其中一个,无法突破全部的算力瓶颈。 刚刚的AICC(人工智能计算大会)2026上,IDC发布了《2026年中国人工智能计算力发展评估报告》,把这两个方向拆开讲了一遍。 「一分为二」的算力缺口 Agent大爆发以后,AI对算力的需求正在发生质变。 过去,人们使用大模型时,算力调用更像是「脉冲式」的,用户问一个问题,系统返回一个答案,只调用一次算力。 但在Agent接管任务之后,情况变了。一个人类意图可能触发几十次、几百次连续推理;多个Agent组成协作网络之后,系统连续运转的时长,还能进一步增加到几个小时甚至好几天。 原本一次次短暂发生的算力请求,开始变成持续不断的计算负载,并进一步给基础设施带来新的压力。 这种长流的压力,可以拆解出三个影响因子。 第一个是任务执行次数,IDC报告显示,到2030年,全球每年的AI推理任务将增长4000万亿次; 第二个是单任务Token消耗量,过去一次简单问答只消耗几十个Token,现在一次多轮任务决策要消耗几十万个; |
| |||||||||||||||||||||
点击朱笔,直抒胸臆